Quay lại danh sáchNhu cầu

Scraping Mercado Libre 2026: Cách Dùng Proxy Để Thu Thập Giá Theo Khu Vực

Tìm hiểu cách scraping Mercado Libre theo từng khu vực bằng Proxy, từ Residential Proxy, IP location đến Sticky Session và cách kiểm tra dữ liệu giá chính xác.

Do Ky Anh
Do Ky Anh
12/09/2026
8 phút đọc
Nhu cầu#mercado libre#scraping#proxy#residential proxy#web scraping#sticky session#ecommerce#data scraping+2
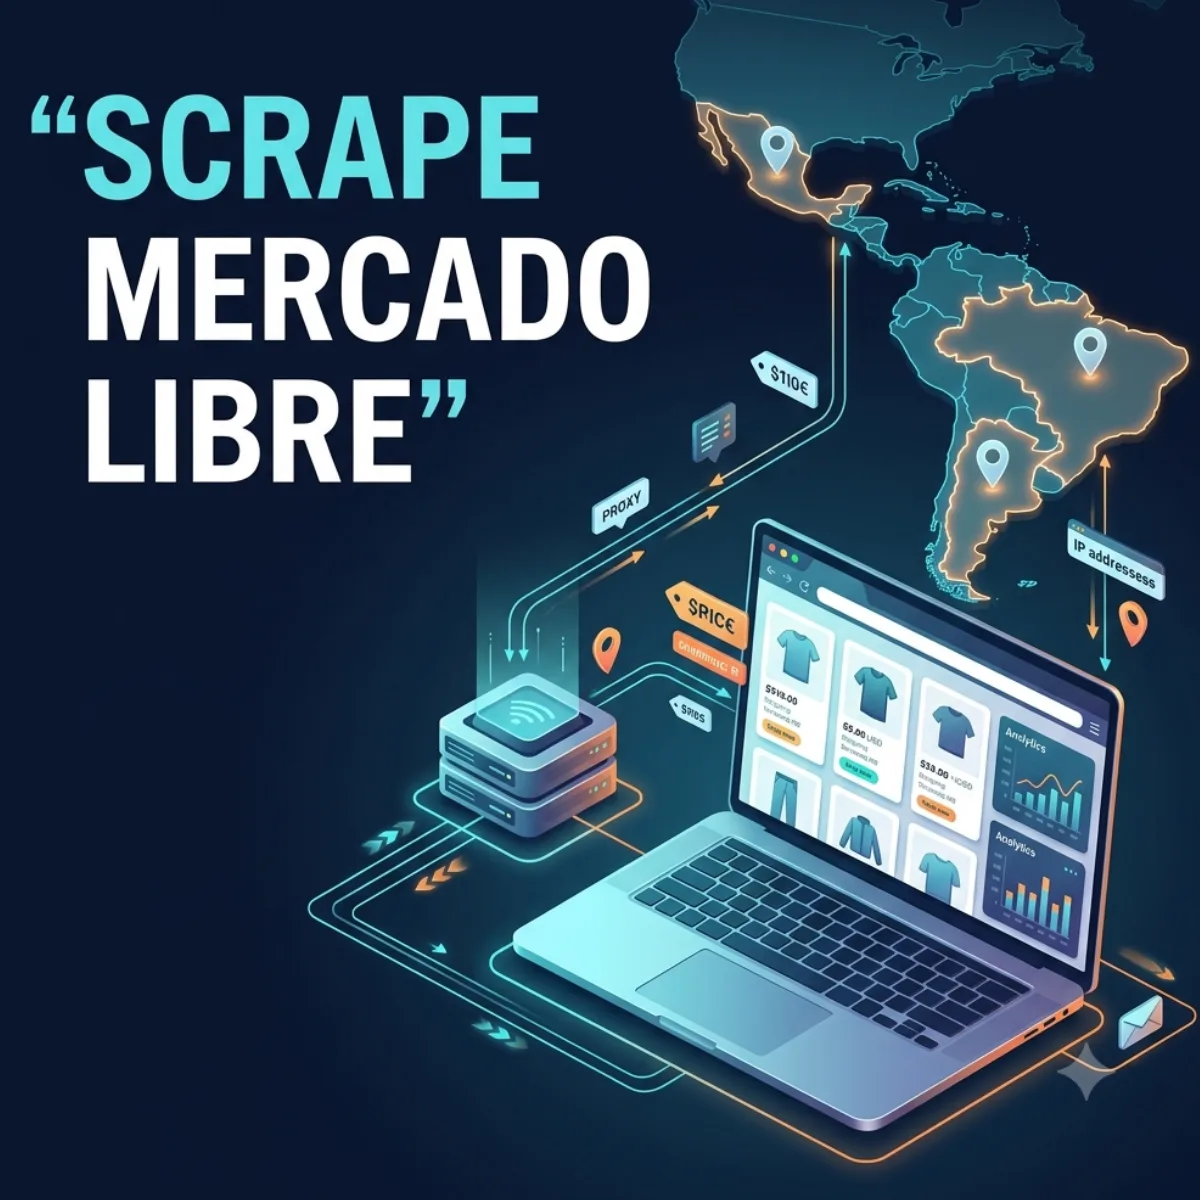
Scraping Mercado Libre 2026: Cách Dùng Proxy Để Thu Thập Giá Theo Khu Vực

Khi scrape một sàn thương mại điện tử, lấy được HTML và giá sản phẩm chưa có nghĩa là bạn đã có dữ liệu chính xác.

Với Mercado Libre, khu vực giao hàng có thể ảnh hưởng đến giá, phí vận chuyển, thời gian giao hàng và cả sản phẩm/người bán được ưu tiên hiển thị. Nếu scraper không xác định đúng khu vực, bạn có thể đang thu thập dữ liệu của một khu vực mặc định thay vì toàn bộ thị trường.

Đây là lý do proxy và session management trở thành một phần quan trọng khi xây dựng hệ thống scraping Mercado Libre.

Mercado Libre có thể trả dữ liệu khác nhau theo khu vực

Mercado Libre hoạt động tại nhiều thị trường ở Mỹ Latinh như Argentina, Brazil, Mexico, Chile, Colombia, Uruguay, Peru và Venezuela.

Mỗi thị trường có:

  • Domain riêng.

  • Đồng tiền riêng.

  • Hệ thống giao hàng riêng.

  • Người bán và sản phẩm có thể khác nhau.

  • Quy tắc hiển thị giá và vận chuyển khác nhau.

Vì vậy, nếu muốn phân tích giá Mercado Libre một cách nghiêm túc, không nên xem toàn bộ dữ liệu là một tập dữ liệu duy nhất.

Bạn nên xác định rõ:

Quốc gia → khu vực → mã bưu chính → phiên scraping → dữ liệu sản phẩm.

Vì sao scraper có thể lấy sai giá?

Một lỗi rất dễ bỏ qua là scraper không chỉ định địa chỉ giao hàng.

Khi người dùng chưa thiết lập khu vực, website có thể sử dụng một khu vực mặc định. Khi đó các thông tin như giá, giao hàng miễn phí hoặc lựa chọn người bán có thể được tính dựa trên khu vực này.

Điều nguy hiểm là scraper vẫn nhận được dữ liệu hợp lệ.

Không có exception.

Không có HTTP error.

Không có dấu hiệu rõ ràng cho thấy dữ liệu sai.

Bạn vẫn có thể lưu hàng chục nghìn sản phẩm vào database và chỉ phát hiện vấn đề sau khi báo cáo hoàn thành.

Cách kiểm tra

Khi scraper nhận HTML, hãy kiểm tra các thông tin liên quan đến location/session thay vì chỉ lấy price.

Ví dụ logic có thể là:

Target location

      ↓

Set delivery address

      ↓

Create scraping session

      ↓

Request product/search page

      ↓

Validate location

      ↓

Extract price + shipping

      ↓

Save data


Nếu khu vực thực tế không khớp với khu vực mục tiêu, tốt nhất không lưu record đó.

Tại sao Proxy quan trọng khi scrape Mercado Libre?

Nếu mọi request đều xuất phát từ một IP máy chủ, website có thể nhìn thấy một lượng lớn request đến từ cùng một nguồn.

Điều này tạo ra hai vấn đề:

  1. IP có thể bị giới hạn hoặc yêu cầu xác minh.

  2. IP máy chủ không phản ánh tốt trải nghiệm của người dùng tại khu vực mục tiêu.

Ví dụ, bạn muốn nghiên cứu giá sản phẩm tại Argentina nhưng scraper chạy từ một server ở Mỹ.

Website có thể nhìn thấy:

Scraper

   ↓

US Datacenter IP

   ↓

Mercado Libre Argentina


Trong khi dữ liệu bạn thực sự muốn là:

Scraper

   ↓

Argentina Residential Proxy

   ↓

Mercado Libre

   ↓

Khu vực giao hàng mục tiêu


Proxy không tự động đảm bảo dữ liệu chính xác, nhưng nó giúp request có ngữ cảnh mạng phù hợp hơn với thị trường cần nghiên cứu.

Residential Proxy hay Datacenter Proxy?

Đây là lựa chọn quan trọng khi xây dựng scraper.

Datacenter Proxy

Datacenter Proxy thường có ưu điểm:

  • Tốc độ cao.

  • Chi phí thấp hơn trong nhiều trường hợp.

  • Phù hợp với các request nhẹ.

  • Dễ mở rộng số lượng IP.

Nó phù hợp cho các tác vụ như:

  • Kiểm tra website.

  • Thu thập robots.txt.

  • Phân tích cấu trúc HTML.

  • Testing scraper.

Tuy nhiên, với những website có hệ thống đánh giá IP nghiêm ngặt, datacenter proxy có thể không phải lựa chọn tối ưu cho scraping quy mô lớn.

Residential Proxy

Residential Proxy sử dụng địa chỉ IP gắn với mạng Internet của người dùng thực tế.

Điểm mạnh:

  • IP có ngữ cảnh địa lý tốt hơn.

  • Phù hợp với các bài toán cần xác định quốc gia/khu vực.

  • Thường phù hợp hơn với các website thương mại điện tử.

Nếu mục tiêu là thu thập giá theo từng khu vực, Residential Proxy thường là lựa chọn đáng cân nhắc hơn.

Session là yếu tố quan trọng không kém Proxy

Một sai lầm khác là thay IP liên tục trong cùng một phiên.

Ví dụ:

Request 1 → IP A

Request 2 → IP B

Request 3 → IP C

Request 4 → IP D


Website có thể nhìn thấy một session thay đổi mạng liên tục.

Thay vào đó, hãy giữ một IP ổn định trong một khoảng thời gian:

Session Argentina

    ↓

IP Argentina

    ↓

Request 1

Request 2

Request 3

Request 4

    ↓

Kết thúc session


Sau đó mới tạo session mới nếu cần.

Đây thường được gọi là sticky session hoặc session persistence.

Scraping bằng Playwright thay vì HTTP request đơn giản

Không phải website nào cũng hoạt động tốt với một HTTP client thuần túy.

Một số trang có thể sử dụng JavaScript để:

  • Khởi tạo session.

  • Kiểm tra trình duyệt.

  • Thiết lập cookie.

  • Hiển thị nội dung động.

  • Thực hiện các bước xác minh.

Trong trường hợp đó, Playwright có thể phù hợp hơn requests hoặc httpx.

Kiến trúc cơ bản:

Playwright

    ↓

Residential Proxy

    ↓

Mercado Libre

    ↓

Browser Session

    ↓

Set Location

    ↓

Load Search/Product Page

    ↓

Validate Location

    ↓

Extract Data


Không nên mặc định rằng browser automation sẽ luôn vượt qua mọi cơ chế bảo vệ. Hãy tuân thủ điều khoản sử dụng và robots.txt của website, đồng thời giữ tốc độ request ở mức hợp lý.

Đừng chỉ lưu mỗi giá sản phẩm

Một scraper tốt nên lưu cả metadata để có thể kiểm tra dữ liệu sau này.

Ví dụ:

{

    "product_id": "...",

    "price": 125000,

    "currency": "ARS",

    "zipcode": "1430",

    "country": "AR",

    "user_zone": "...",

    "shipping": "...",

    "scraped_at": "2026-09-12T10:00:00Z"

}


Điều này đặc biệt quan trọng khi bạn muốn xây dựng hệ thống:

  • Price monitoring.

  • Competitive intelligence.

  • Market research.

  • Price comparison.

  • E-commerce analytics.

Nếu chỉ lưu:

product_id + price


thì sau này rất khó xác định mức giá đó thuộc khu vực nào và được thu thập trong session nào.

Chuẩn hóa tiền tệ trước khi phân tích

Một vấn đề khác khi scrape nhiều quốc gia là tiền tệ.

Ví dụ:

Argentina → ARS

Brazil   → BRL

Mexico   → MXN

Chile    → CLP


Không nên lấy giá từ các thị trường khác nhau rồi so sánh trực tiếp.

Database nên giữ cả:

original_price

original_currency

exchange_rate

normalized_price

normalized_currency

scraped_at


Như vậy bạn vẫn có thể tính toán lại dữ liệu khi tỷ giá thay đổi.

Checklist xây scraper Mercado Libre

Trước khi chạy scraper quy mô lớn, hãy kiểm tra:

  • Đã xác định quốc gia cần scrape.

  • Đã xác định khu vực hoặc mã bưu chính.

  • Proxy có location phù hợp.

  • IP được giữ ổn định trong session.

  • Session/cookie được quản lý đúng.

  • Đã kiểm tra location sau khi thiết lập.

  • Đã lưu currency.

  • Đã lưu timestamp.

  • Có rate limit hợp lý.

  • Có retry và error handling.

  • Đã kiểm tra robots.txt và điều khoản sử dụng.

  • Không thu thập dữ liệu cá nhân hoặc khu vực tài khoản riêng tư.

Kết luận

Scraping Mercado Libre không chỉ đơn giản là gửi request rồi lấy giá từ HTML.

Nếu mục tiêu là xây dựng dữ liệu phục vụ price monitoring hoặc market research, bạn cần quan tâm đến cả:

IP → Location → Session → Browser → Currency → Validation.

Trong đó, location là một trong những yếu tố dễ bị bỏ qua nhất.

Một hệ thống scraping tốt không chỉ trả lời được:

"Sản phẩm này có giá bao nhiêu?"

mà còn phải trả lời được:

"Giá này được ghi nhận ở đâu, bằng IP nào, trong session nào và tại thời điểm nào?"

Đó mới là dữ liệu có thể kiểm chứng và sử dụng cho phân tích thực tế.

Gợi ý lựa chọn Proxy

Nếu cần thu thập dữ liệu theo quốc gia/khu vực, hãy ưu tiên loại proxy có geolocation rõ ràng và hỗ trợ session ổn định.

Với các tác vụ kiểm tra website hoặc testing scraper, Datacenter Proxy có thể là lựa chọn tiết kiệm hơn. Với các bài toán cần dữ liệu địa phương và độ ổn định session cao hơn, Residential Proxy đáng cân nhắc.


Bài viết liên quan

Blog - kaproxy.cloud